참조 사이트
- Grafana Alloy - Introduction
- Grafana Alloy - How Alloy works
- Grafana Tempo - Traces and telemetry
- Grafana Alloy - Collect Prometheus metrics
- Grafana Alloy - loki.source.file
- Grafana Alloy - otelcol.receiver.otlp
- Grafana Tempo - Configure Alloy to send data to Tempo
- Prometheus - Frequently Asked Questions
- Prometheus - Instrumentation
- Prometheus - Metric types
- OpenTelemetry - Metrics
개요
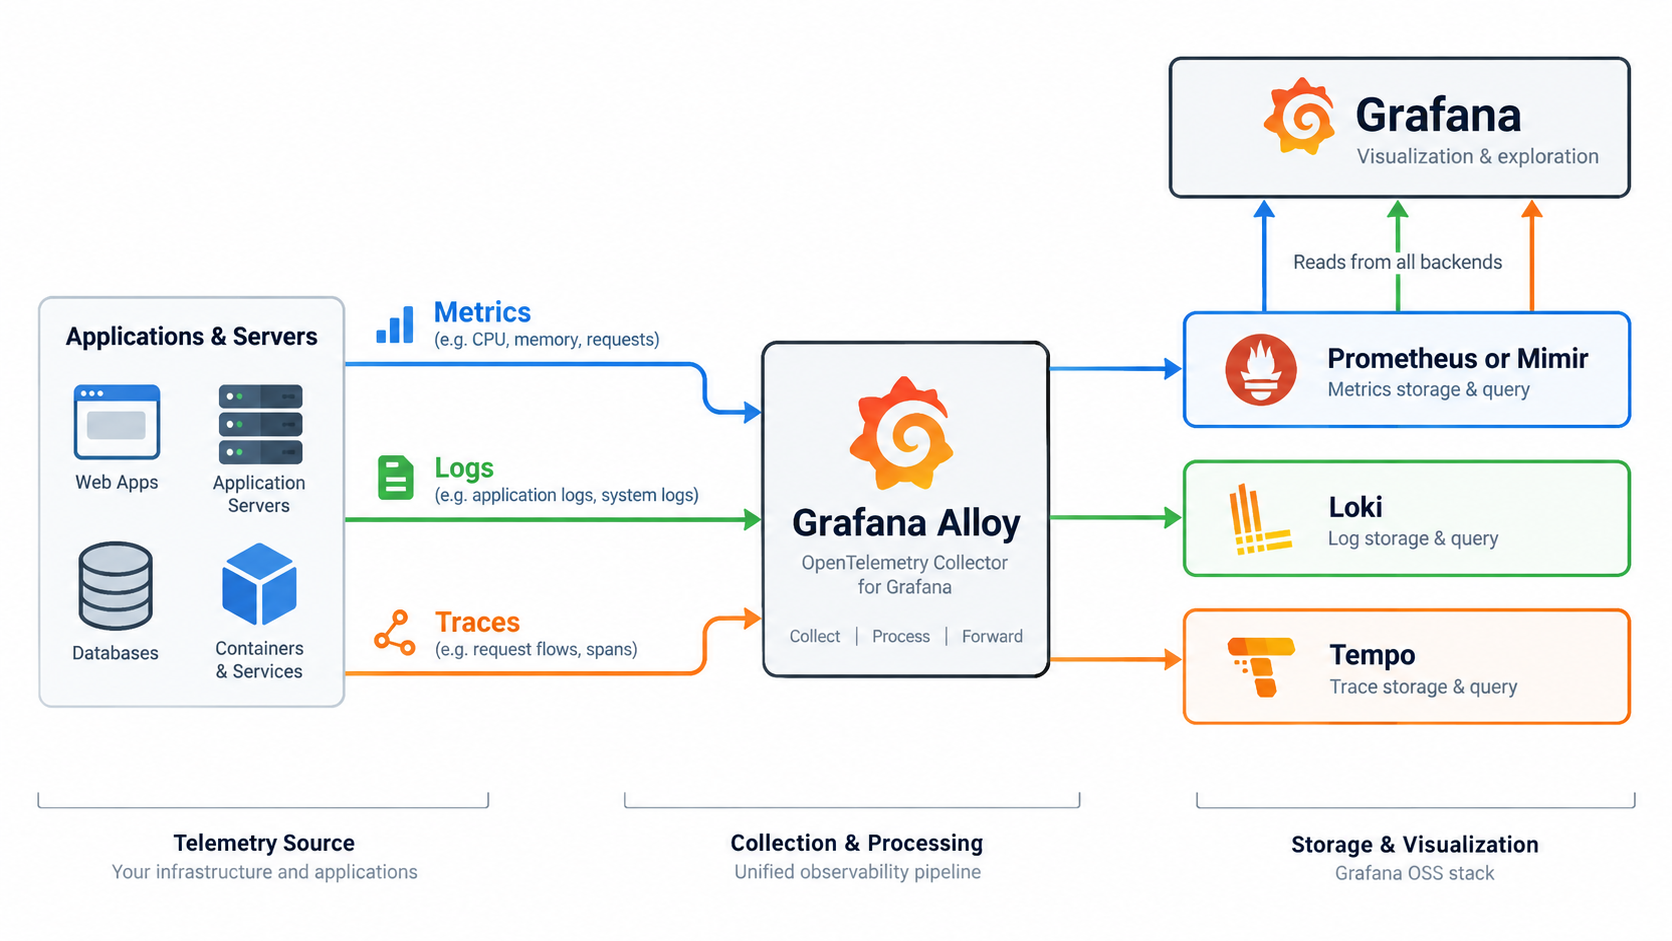
관측성(Observability)을 구성하는 대표적인 텔레메트리 데이터에는 메트릭(Metrics), 로그(Logs), 트레이스(Traces)가 있다. 세 데이터는 모두 시스템의 상태를 관찰하기 위해 사용하지만, 표현하는 정보와 수집 방식은 서로 다르다.
Grafana 생태계에서는 일반적으로 메트릭을 Prometheus 또는 Mimir, 로그를 Loki, 트레이스를 Tempo에 저장한다. 여기에 Grafana Alloy를 도입하면 여러 종류의 텔레메트리를 하나의 수집 계층에서 받아 가공하고 각 백엔드로 전달할 수 있다.
그러나 각 제품의 역할을 명확히 구분하지 않으면 다음과 같은 의문이 생긴다.
- Prometheus와 Alloy는 서로 대체 관계인가?
- Loki나 Tempo가 직접 데이터를 수집하는가?
- Alloy로 메트릭만 수집할 수 있는가?
- 하나의 Alloy가 메트릭, 로그, 트레이스를 모두 처리할 수 있는가?
- 지속해서 발생하는 메트릭은 Pull보다 Push 방식이 적합하지 않은가?
이번 글에서는 메트릭·로그·트레이스의 차이를 먼저 살펴보고, 데이터 발생 지점 → Alloy → 저장 백엔드로 이어지는 수집 파이프라인을 기준으로 Push와 Pull 방식을 정리한다.
💡 용어 사전: 텔레메트리(Telemetry)
원격 시스템에서 생성되는 상태와 동작 데이터를 자동으로 수집하고 전송하는 기술을 의미한다. 메트릭, 로그, 트레이스는 관측성을 구성하는 대표적인 텔레메트리 신호이다.
1. 관측성을 구성하는 세 가지 신호
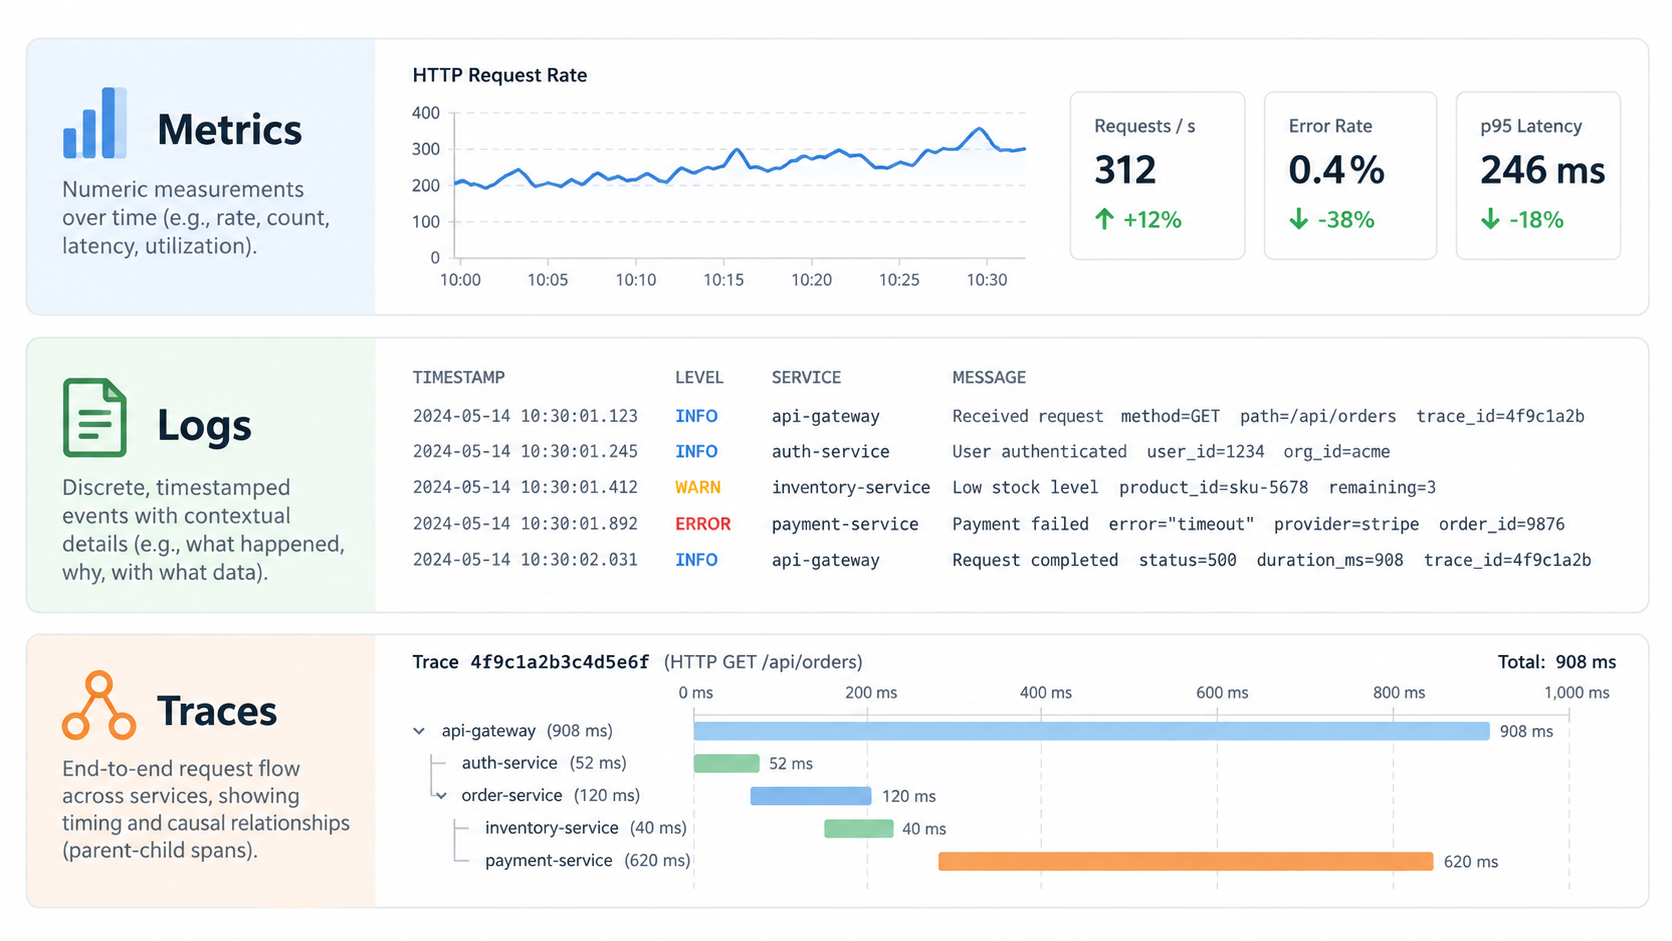
① 메트릭(Metrics): 일정 시점의 상태를 수치로 표현
메트릭은 시스템의 상태를 숫자로 표현한 시계열(Time Series) 데이터이다. 각 값은 측정 시각과 레이블(Label) 집합을 기준으로 저장된다.
대표적인 메트릭은 다음과 같다.
- HTTP 요청 누적 횟수
- 초당 요청 처리량
- 오류 발생률
- 응답 시간 분포
- CPU 및 메모리 사용량
- 현재 처리 중인 요청 수
예를 들어 Prometheus 형식의 HTTP 요청 메트릭은 다음과 같이 표현할 수 있다.
http_requests_total{method="GET", status="200"} 1250
http_requests_total{method="GET", status="500"} 17
메트릭은 개별 요청의 세부 내용을 보존하기보다는 시스템 전체의 변화와 추세를 압축하여 나타낸다. 따라서 "현재 시스템에 이상이 발생했는가?"를 빠르게 파악하는 데 적합하다.
② 로그(Logs): 특정 시점에 발생한 개별 사건을 기록
로그는 애플리케이션이나 운영체제에서 발생한 개별 이벤트를 시간 순서대로 기록한 데이터이다.
2026-09-22T10:15:31Z INFO  order created orderId=1024
2026-09-22T10:15:32Z ERROR payment failed orderId=1024 code=TIMEOUT
로그에는 이벤트 발생 시각, 로그 레벨, 메시지, 예외 스택, 사용자나 요청을 식별하기 위한 값 등이 포함될 수 있다. 메트릭보다 데이터양은 크지만, 특정 시점에 어떤 사건이 발생했는지 자세히 확인할 수 있다.
③ 트레이스(Traces): 하나의 요청이나 작업이 이동한 전체 경로를 표현
트레이스는 하나의 요청이나 작업이 여러 서비스와 데이터 저장소를 통과한 전체 경로를 표현한다. 분산 시스템에서 작업이 어느 구간을 거쳤고, 각 구간에서 얼마의 시간이 소요되었는지를 연결해서 보여준다.
전체 작업 흐름을 Trace, 이를 구성하는 개별 작업 단위를 Span이라고 한다.
Trace: 주문 생성 요청
├─ Span 1: API Gateway                 20 ms
├─ Span 2: Order Service             180 ms
│  ├─ Span 3: MySQL INSERT            35 ms
│  └─ Span 4: Payment Service        120 ms
└─ Span 5: Kafka Publish              15 ms
각 Span은 Trace ID와 Parent Span ID를 통해 부모·자식 관계로 연결된다. 비동기 작업처럼 별도의 인과관계를 표현할 때는 Span Link를 사용할 수도 있다. 이를 통해 단순히 "요청이 느리다"는 사실뿐 아니라 지연이 발생한 서비스와 호출 구간을 찾을 수 있다.
같은 요청에서 생성된 로그에 Trace ID가 함께 기록되면 특정 로그 이벤트와 해당 요청의 전체 Trace를 연결할 수도 있다.
Grafana 생태계에서 트레이스를 저장하고 조회하는 백엔드는 Tempo이다.
2. Collector와 Backend는 역할이 다르다
Grafana 관측성 스택을 이해할 때 가장 중요한 것은 수집기(Collector)와 저장 백엔드(Backend)를 구분하는 것이다.
- Collector: 데이터를 발견하고 수집한 뒤 가공하여 다른 시스템으로 전달한다.
- Backend: 전달받은 데이터를 저장하고 검색 또는 질의할 수 있도록 제공한다.
- Visualization: 백엔드에 질의하여 결과를 대시보드와 그래프로 표현한다.
| 관측 신호 | 수집 계층 | 저장·조회 백엔드 | 대표 질의 언어 |
| Metrics | Prometheus 또는 Alloy | Prometheus / Mimir | PromQL |
| Logs | Alloy | Loki | LogQL |
| Traces | Alloy / OpenTelemetry Collector | Tempo | TraceQL |
Prometheus는 조금 특별하다. Prometheus 서버는 대상의 /metrics 엔드포인트를 직접 스크랩하는 Collector 역할과 수집한 시계열을 자체 TSDB에 저장하는 Backend 역할을 함께 수행할 수 있다.
반면 Alloy는 텔레메트리를 장기간 저장하고 질의하는 백엔드가 아니다. Alloy는 데이터 소스와 백엔드 사이에 위치하여 메트릭, 로그, 트레이스 및 프로파일을 수집하고 가공한 뒤 호환되는 백엔드로 전달하는 수집기이다.
따라서 다음 표현은 역할을 지나치게 단순화한다.
Prometheus 또는 Alloy
Loki 또는 Alloy
Tempo 또는 Alloy
정확한 관계는 다음과 같다.
Metrics 수집 : Prometheus/Alloy ── GET /metrics ──→ Application
Metrics 전달 : Alloy ── Remote Write ──→ Prometheus/Mimir

Logs 수집    : Alloy ── Tail/Read ──→ Log File
Logs 전달    : Alloy ── HTTP Push ──→ Loki

Traces 전달  : Application ── OTLP Push ──→ Alloy ── OTLP Push ──→ Tempo
위 도식에서 화살표는 네트워크 요청 또는 읽기 동작을 시작하는 주체의 방향을 나타낸다. 실제 데이터 응답은 요청의 반대 방향으로 돌아올 수 있다.
💡 핵심 정리
Alloy는 Prometheus·Loki·Tempo 전체를 대체하는 제품이 아니라, 각 백엔드 앞에서 텔레메트리 수집 파이프라인을 통합하는 제품이다.
3. Grafana Alloy는 무엇인가?
Grafana Alloy는 OpenTelemetry Collector 배포판을 기반으로 하며, Prometheus 파이프라인과 Loki, Tempo, Pyroscope 등 Grafana 생태계에 대한 지원을 결합한 오픈소스 텔레메트리 수집기이다.
Alloy 설정은 여러 Component를 연결하여 하나의 데이터 흐름으로 구성된다.
Receiver / Source → Processor → Exporter / Write각 Component는 다음 중 하나의 역할을 수행한다.
- 발견(Discovery): 수집할 서버, 컨테이너 또는 Pod를 찾는다.
- 수집(Receive / Scrape / Read): 메트릭, 로그, 트레이스를 받아온다.
- 가공(Process): 필터링, 레이블 변경, 배치 처리 등을 수행한다.
- 전달(Export / Write): 가공한 데이터를 백엔드로 전송한다.
Alloy는 필요한 Component만 선언하여 사용할 수 있다. 따라서 메트릭만 수집하거나, 로그만 수집하거나, 세 신호를 하나의 Alloy에서 모두 수집하는 구성이 가능하다.
① Alloy로 메트릭만 수집
Alloy ── GET /metrics ──→ Application
Alloy ── Remote Write Push ──→ Prometheus/Mimir
② Alloy로 로그만 수집
Alloy ── Tail/Read ──→ Log File
Alloy ── HTTP Push ──→ Loki
③ Alloy로 트레이스만 수집
Application — OTLP Push → Alloy — OTLP Push → Tempo④ 하나의 Alloy로 세 신호를 모두 수집
                         ┌─ Metrics ─→ Prometheus/Mimir
Application / Server ─→ Alloy
                         ├─ Logs ────→ Loki
                         └─ Traces ──→ Tempo
Alloy를 사용한다고 해서 세 신호를 반드시 모두 활성화해야 하는 것은 아니다. 설정 파일에 선언한 Component와 연결된 파이프라인만 실행된다.
4. Push와 Pull은 신호가 아니라 수집 구간과 주체에 따라 결정된다
Push와 Pull은 메트릭, 로그, 트레이스에 고정된 속성이 아니다. 동일한 서버나 운영체제에서 생성된 텔레메트리도 수집 구성에 따라 Pull 또는 Push 방식으로 전달할 수 있다.
수집 방식을 구분하는 기준은 어느 쪽이 데이터 전송을 시작하는가이다.
- Pull: Collector가 데이터 발생 지점에 먼저 요청한다.
- Push: 애플리케이션, SDK 또는 Agent가 Collector의 수신 주소로 먼저 전송한다.
전체 파이프라인은 다음 두 구간으로 나누어 살펴봐야 한다.
[서버·OS·애플리케이션] → [Collector] → [저장 Backend]① Collector가 서버나 애플리케이션에서 Pull하는 경우
서버 또는 애플리케이션이 /metrics 엔드포인트를 노출하면 Prometheus나 Alloy가 일정한 주기로 HTTP 요청을 보내 값을 가져간다. Node Exporter와 같은 Exporter를 사용하는 서버·OS 메트릭도 이 구조에 해당한다.
1. Alloy/Prometheus ── GET /metrics ──→ Application/Exporter
2. Application/Exporter ── Metrics Response ──→ Alloy/Prometheus
로그 파일 수집도 넓게 보면 Collector가 데이터를 읽는 구조이다. 서버에 설치된 Alloy가 로그 파일을 지속해서 Tail/Read하고 새로 추가된 로그를 가져간다. 다만 이는 원격 HTTP 요청이 아니므로 Prometheus의 네트워크 Pull과 구분하여 파일 테일링이라고 표현하는 편이 정확하다.
② 서버나 애플리케이션에서 Collector로 Push하는 경우
애플리케이션의 OpenTelemetry SDK나 서버에 설치된 Agent가 Collector의 수신 주소를 알고 있다면 텔레메트리를 직접 Push할 수 있다.
Application SDK ── OTLP Push ──→ Alloy
Server Agent     ── OTLP/Remote Write Push ──→ Alloy
System           ── Syslog Push ──→ Alloy
따라서 메트릭도 반드시 Pull만 사용하는 것은 아니다. Prometheus 형식 메트릭은 /metrics를 스크랩하는 Pull 방식이 일반적이지만, OpenTelemetry Metrics나 Agent가 수집한 메트릭은 OTLP 또는 Remote Write를 통해 Push할 수 있다.
③ Collector에서 저장 Backend로 전달하는 구간
서버에서 Pull 또는 Push 중 어떤 방식으로 수집했더라도 Alloy가 가공한 데이터는 일반적으로 각 저장 Backend로 Push된다.
Alloy ── Remote Write Push ──→ Prometheus 호환 Metrics Backend
Alloy ── Loki Push ─────────→ Loki
Alloy ── OTLP Push ─────────→ Tempo
즉 하나의 파이프라인에서도 서로 다른 방식이 결합될 수 있다.
Application/Exporter ← Pull ── Alloy ── Push → 저장 Backend

또는

Application/Agent ── Push → Alloy ── Push → 저장 Backend| 방식 | 전송 시작 주체 | 대표적인 수집 형태 | 데이터 흐름 |
| Pull | Collector | Prometheus Scrape, Node Exporter, /metrics |
Source → Collector 응답 |
| Push | Application / SDK / Agent | OTLP, Syslog, Remote Write | Source → Collector 전송 |
④ Metrics와 Logs는 언제 Pull과 Push를 선택하는가?

Metrics는 Pull을 기본으로 고려한다
다음 조건에서는 Pull 방식이 적합하다.
- 애플리케이션이나 서버가 계속 실행되는 장기 실행 프로세스인 경우
- 애플리케이션, Node Exporter 등이
/metrics엔드포인트를 안정적으로 제공하는 경우 - Prometheus 또는 Alloy가 네트워크를 통해 수집 대상에 접근할 수 있는 경우
- Service Discovery로 수집 대상을 자동으로 찾고 관리하려는 경우
- 스크랩 성공 여부를 나타내는
up메트릭으로 대상의 생존 상태도 함께 확인하려는 경우
Prometheus의 기본 모델은 Pull이다. Collector가 수집 주기를 통제할 수 있고, 수집 대상이 응답하지 않으면 스크랩 실패 자체를 장애 신호로 사용할 수 있다.
다음 조건에서는 Metrics Push를 고려할 수 있다.
- Collector가 스크랩하기 전에 종료되는 짧은 Batch Job의 실행 결과를 남겨야 하는 경우
- 서버 내부의 Agent가 메트릭을 수집하고 중앙 Collector나 원격 Backend로 전달하는 구조인 경우
- 외부 Collector가 서버 내부로 접근할 수 없고, 서버에서 외부로 나가는 연결만 허용되는 경우
- OpenTelemetry Metrics를 사용하여 SDK 또는 Agent가 OTLP로 전송하는 경우
짧은 Batch Job에서는 Pushgateway를 사용할 수 있다. 이때 Batch Job이 Pushgateway로 값을 Push하고, Prometheus는 Pushgateway를 다시 Pull한다.
Batch Job ── Push ──→ Pushgateway ←── Pull ── PrometheusPushgateway는 일반적인 서버 메트릭을 모두 Push 방식으로 바꾸기 위한 도구가 아니다. Pushgateway에 저장된 시계열은 원본 프로세스가 종료되어도 자동으로 사라지지 않으며, Prometheus의 up 메트릭을 통한 개별 대상 상태 확인도 어려워진다. 따라서 일반적인 장기 실행 서비스에는 Pull을 우선하고, Pushgateway는 짧은 서비스 단위 Batch Job처럼 제한된 경우에 사용하는 것이 적합하다.
Logs는 파일을 읽은 뒤 Push하는 구성이 일반적이다
로그는 메트릭과 달리 중앙 시스템이 애플리케이션의 로그 엔드포인트를 주기적으로 스크랩하는 형태를 일반적으로 사용하지 않는다.
로그가 서버의 파일, 컨테이너 표준 출력 또는 Systemd Journal에 기록된다면 서버와 가까운 위치의 Agent가 이를 읽는 방식이 적합하다.
- 로그가 로컬 파일에 계속 추가되는 경우
- Docker 또는 Kubernetes의 컨테이너 로그를 수집하는 경우
- Systemd Journal이나 Windows Event Log를 읽는 경우
- 애플리케이션 코드를 수정하지 않고 기존 로그를 수집하려는 경우
Log File / stdout / Journal ← Tail·Read ── Alloy
Alloy ── Push ──→ Loki
반면 다음 조건에서는 애플리케이션이나 시스템이 로그를 Collector로 직접 Push하는 구성이 적합하다.
- 애플리케이션이 OpenTelemetry Logs를 사용하여 OTLP로 전송하는 경우
- 네트워크 장비나 운영체제가 Syslog를 외부 Receiver로 전송하는 경우
- 로컬 파일을 남기지 않고 중앙 Collector로 로그를 바로 전달하는 구조인 경우
- 서버의 Agent가 여러 로그 소스를 모아서 중앙 Alloy Gateway로 전달하는 경우
Application ── OTLP Logs Push ──→ Alloy
System/Network Device ── Syslog Push ──→ Alloy
Edge Alloy ── Push ──→ Central Alloy/Loki
따라서 로그는 단순히 Pull 또는 Push 중 하나로 분류하기보다 다음 두 단계로 이해하는 편이 정확하다.
로컬 수집: Agent가 File/stdout/Journal을 Tail·Read
원격 전달: Agent가 수집한 Logs를 Loki 또는 중앙 Collector로 Push| 신호 | Pull·Read가 적합한 경우 | Push가 적합한 경우 | 일반적인 기본 구조 |
| Metrics | 장기 실행 서비스, /metrics, Exporter, Service Discovery |
짧은 Batch Job, OTLP Metrics, 서버 Agent의 원격 전달 | Pull Scrape |
| Logs | File, stdout, Journal처럼 로컬에 기록된 로그 | OTLP Logs, Syslog, Agent·Gateway 전달 | Local Tail/Read → Push |
Trace는 일반적으로 애플리케이션 SDK나 Agent가 생성한 Span을 OTLP로 Collector에 전송하므로 Push 방식으로 처리한다. 따라서 Metrics와 Logs에 비해 Pull과 Push를 선택하는 문제는 크지 않다.
여기서 Push는 이벤트가 발생할 때마다 데이터를 한 건씩 즉시 전송한다는 뜻이 아니다. SDK, Agent 또는 Collector가 데이터를 일정 시간 버퍼링하거나 여러 샘플을 묶어 주기적으로 전송할 수도 있다.
5. 계속 발생하는 메트릭을 Pull 방식으로 수집해도 되는 이유
메트릭이 계속 발생한다면 이벤트가 발생할 때마다 바로 Push해야 할 것처럼 보인다.
결론부터 말하면 Prometheus 형식 메트릭은 일반적으로 이벤트별 메시지를 외부로 전송하기보다, 계측 라이브러리나 Exporter가 제공하는 누적값 또는 현재 상태를 /metrics 엔드포인트로 노출하고 이를 주기적으로 스크랩한다. 따라서 메트릭이 계속 갱신된다는 이유만으로 매번 즉시 Push할 필요는 없다.
OpenTelemetry Metrics는 SDK가 수집·집계한 값을 Export 주기에 맞춰 Collector로 Push할 수도 있다. 이때에도 모든 이벤트를 개별 메시지로 전송하는 것이 아니라 SDK의 집계 방식과 Delta 또는 Cumulative Temporality에 따라 값을 전달한다.
① Counter는 발생 횟수를 누적한다
HTTP 요청이 들어올 때마다 다음 메시지를 외부로 전송하는 것이 아니다.
요청 발생 → "요청 1건 발생" Push
요청 발생 → "요청 1건 발생" Push
대신 애플리케이션 내부의 Counter 값을 증가시킨다.
http_requests_total = 100
요청 1건 발생 → 101
요청 1건 발생 → 102
요청 1건 발생 → 103
Prometheus 또는 Alloy는 설정된 Scrape Interval마다 /metrics를 호출하여 그 시점의 누적값을 가져간다.
10:00:00 Scrape → http_requests_total = 100
10:00:15 Scrape → http_requests_total = 130
15초 동안 30건의 요청이 발생했더라도 Counter가 값을 누적하고 있으므로 두 샘플의 차이를 통해 증가량을 계산할 수 있다.
요청 증가량 = 130 - 100 = 30
평균 요청률 = 30 / 15초 = 초당 2건
PromQL에서는 rate() 또는 increase()를 사용하여 Counter의 증가량을 계산한다.
increase(): 지정한 구간 동안 Counter가 증가한 양을 계산한다.rate(): 지정한 구간에서 Counter의 초당 평균 증가율을 계산한다.
rate(http_requests_total[5m])Counter는 일반적으로 단조 증가하지만 프로세스가 재시작되면 0으로 재설정될 수 있다. PromQL의 rate()와 increase()는 이러한 Counter Reset을 고려하여 계산한다.
② Classic Histogram도 관측 결과를 누적한다
여기서는 Prometheus의 Classic Histogram을 기준으로 설명한다. Classic Histogram은 요청마다 측정한 응답 시간을 le 상한값 이하의 누적 버킷 카운터와 전체 합계에 기록한다. 따라서 각 _bucket 값은 서로 독립된 구간의 개수가 아니라 해당 상한값 이하에 속한 관측값의 누적 개수이다.
http_request_duration_seconds_bucket{le="0.1"} 80
http_request_duration_seconds_bucket{le="0.5"} 120
http_request_duration_seconds_bucket{le="1.0"} 128
http_request_duration_seconds_bucket{le="+Inf"} 130
http_request_duration_seconds_count 130
http_request_duration_seconds_sum 24.7
Prometheus가 모든 요청 시간을 개별적으로 가져가지 않더라도 각 버킷의 누적값을 통해 응답 시간 분포를 계산할 수 있다. le="+Inf" 버킷은 모든 관측값을 포함하므로 그 값은 _count와 같다.
③ Gauge는 순간적인 중간값을 놓칠 수 있다
Gauge는 현재 메모리 사용량, 큐 크기, 처리 중인 요청 수처럼 증가와 감소가 모두 가능한 현재 상태를 표현한다.
10:00:00 → queue_size = 10  // Scrape
10:00:05 → queue_size = 100
10:00:10 → queue_size = 20
10:00:15 → queue_size = 10  // Scrape
Prometheus에는 10:00:00과 10:00:15의 값인 10 → 10만 저장된다. 두 스크랩 사이에서 큐 크기가 100까지 상승했던 순간은 기록되지 않는다.
이는 Pull 방식의 오류가 아니라 메트릭이 일정한 간격으로 시스템 상태를 관측하는 샘플링 데이터이기 때문이다. 순간적인 변화를 더 세밀하게 관찰하려면 Scrape Interval을 줄이거나, 발생 횟수를 Counter로 누적하거나, 값의 분포를 Histogram으로 기록해야 한다.
[이미지 생성 후 이 블록을 이미지로 교체]
Clean white-background time-series educational chart comparing Counter and Gauge under periodic Prometheus scraping. Top graph: a blue monotonic counter staircase increasing continuously, with vertical scrape markers every 15 seconds and sampled dots that still preserve total growth. Bottom graph: a green gauge curve with a sharp transient spike between two scrape markers, showing that the spike is not captured by the sampled dots. Add minimal English labels Counter, Gauge, Scrape every 15s, and Missed transient. Flat vector graph style, thin grid lines, precise axes, no gradients, no 3D, no dark background, 16:9 landscape ratio.
④ 메트릭은 모든 개별 사건을 보존하는 원장이 아니다
Counter도 마지막 스크랩 전에 프로세스가 종료되면 일부 증가량이 수집되지 않을 수 있다.
마지막 Scrape: counter = 100
요청 5건 발생: counter = 105
다음 Scrape 전에 애플리케이션 종료
Prometheus는 105를 한 번도 수집하지 못했으므로 마지막 5건을 알 수 없다. 따라서 Prometheus 메트릭은 시스템의 상태와 추세를 관찰하기 위한 데이터이며, 모든 사건을 100% 보존해야 하는 결제 원장이나 이벤트 저장소와는 목적이 다르다.
💡 핵심 정리
메트릭은 발생한 사건을 하나씩 전송하는 대신 Counter·Gauge·Histogram 형태로 집계한 상태를 일정 간격으로 관측한다. 따라서 메트릭이 계속 갱신된다는 사실만으로 모든 값을 즉시 Push해야 하는 것은 아니다.
6. 메트릭 수집 경로: Pull로 수집하고 Push로 전달
① Prometheus가 직접 스크랩하는 구조
가장 기본적인 Prometheus 구성에서는 Prometheus 서버가 애플리케이션의 /metrics 엔드포인트를 직접 호출한다.
Prometheus ── GET /metrics ──→ Application
Application ── Metrics Response ──→ Prometheus
이 구조에서는 Prometheus가 수집기와 저장소 역할을 모두 수행한다.
② Alloy가 대신 스크랩하는 구조
Alloy의 prometheus.scrape Component가 애플리케이션 메트릭을 Pull하고, prometheus.remote_write Component가 데이터를 Backend로 Push한다. 아래 설정에서 핵심은 scrape → remote_write로 연결되는 데이터 흐름이다.
prometheus.scrape "application" {
  scrape_interval = "15s"

  targets = [
    {
      __address__ = "application:8080",
    },
  ]

  forward_to = [prometheus.remote_write.metrics_backend.receiver]
}

prometheus.remote_write "metrics_backend" {
  endpoint {
    url = "http://prometheus:9090/api/v1/write"
  }
}
데이터 흐름은 다음과 같다.
1. Alloy → Application: GET /metrics
2. Application → Alloy: 현재 Metric 값 응답
3. Alloy → Prometheus: Remote Write로 Metric Push
일반 Prometheus가 Remote Write 데이터를 받으려면 수신 엔드포인트를 활성화해야 한다.
prometheus --web.enable-remote-write-receiver다만 Prometheus의 Remote Write Receiver는 기존 Scrape를 대체하기 위한 일반적인 Push 수집 방식이 아니다. Prometheus 공식 문서에서는 특정 저용량 사용 사례에서 제한적으로 사용할 것을 권장한다. Alloy에서 메트릭을 Remote Write로 전달하는 구조에서는 Mimir, Grafana Cloud Metrics 또는 다른 Prometheus 호환 Backend를 사용할 수 있으며, 제품마다 수신 URL은 달라질 수 있다.
7. 로그 수집 경로: 파일을 읽고 Loki로 Push
파일 기반 로그에서는 Alloy가 지정된 로그 파일을 파일 테일링 방식으로 읽는다. 이는 Prometheus가 HTTP 엔드포인트를 호출하는 네트워크 Pull과는 다르므로 파일 Tailing 또는 File Read라고 구분하는 편이 정확하다.
Alloy ── Tail/Read ──→ Log File
Alloy ── HTTP Push ──→ Loki
Alloy의 loki.source.file Component는 새로 추가된 로그 행을 읽고, loki.write Component는 이를 Loki의 Push API로 전송한다.
loki.source.file "application_logs" {
  targets = [
    {
      __path__ = "/var/log/application/*.log",
      job      = "application",
    },
  ]

  forward_to = [loki.write.loki_backend.receiver]

  file_match {
    enabled = true
  }
}

loki.write "loki_backend" {
  endpoint {
    url = "http://loki:3100/loki/api/v1/push"
  }
}
애플리케이션이 OpenTelemetry Logs를 사용한다면 OTLP로 로그를 Alloy에 Push하는 구성도 가능하다.
Application — OTLP Push → Alloy — HTTP Push → LokiAlloy가 OTLP Logs를 수신한 뒤에는 사용하는 Exporter에 따라 Loki Push API 또는 Loki의 OTLP Logs 엔드포인트로 전달할 수 있다. Loki가 애플리케이션의 로그 파일을 직접 찾아가 Pull하는 구조가 아니라, Alloy와 같은 수집기가 로그를 읽거나 수신하여 Loki로 전달하는 구조이다.
8. 트레이스 수집 경로: OTLP 기반 Push
트레이스는 애플리케이션에 적용된 OpenTelemetry SDK나 에이전트가 Span을 생성하면서 시작된다. 생성된 Span은 일반적으로 OTLP(OpenTelemetry Protocol)를 사용하여 Collector로 Push된다.
Application — OTLP Push → Alloy — OTLP Push → TempoAlloy에서는 otelcol.receiver.otlp가 애플리케이션의 Trace를 수신하고, 배치 프로세서를 거친 뒤 otelcol.exporter.otlp가 Tempo로 전달할 수 있다.
otelcol.receiver.otlp "application" {
  grpc {
    endpoint = "0.0.0.0:4317"
  }

  http {
    endpoint = "0.0.0.0:4318"
  }

  output {
    traces = [otelcol.processor.batch.traces.input]
  }
}

otelcol.processor.batch "traces" {
  output {
    traces = [otelcol.exporter.otlp.tempo.input]
  }
}

otelcol.exporter.otlp "tempo" {
  client {
    endpoint = "tempo:4317"

    tls {
      insecure = true
    }
  }
}
Tempo는 애플리케이션에 접근하여 Trace를 Pull하지 않는다. 애플리케이션 또는 Collector가 생성한 Span을 Tempo의 수신 엔드포인트로 Push한다.
이 구성이 동작하려면 Tempo Distributor의 OTLP gRPC Receiver가 활성화되어 있고 Alloy에서 접근 가능한 주소에 바인딩되어 있어야 한다. 예제의 tls { insecure = true }는 TLS를 사용하지 않는 로컬 구성에 해당한다.
9. Alloy 통합 수집 구조
앞의 세 파이프라인을 하나의 Alloy 설정에서 함께 선언하면 하나의 Alloy 프로세스가 메트릭, 로그, 트레이스를 모두 처리할 수 있다.
┌─────────────────────────────────────────────────────────────┐
│                       Grafana Alloy                         │
│                                                             │
│  prometheus.scrape ───→ prometheus.remote_write ─→ Metrics │
│  loki.source.file ─────→ loki.write ──────────────→ Logs    │
│  otelcol.receiver.otlp → otelcol.exporter.otlp ───→ Traces │
└─────────────────────────────────────────────────────────────┘
다만 하나의 프로세스에서 실행되더라도 내부적으로는 신호별 파이프라인이 분리되어 있다.
Metrics Pipeline : prometheus.* Component
Logs Pipeline    : loki.* Component
Traces Pipeline  : otelcol.* Component
💡 핵심 정리
하나의 Alloy 프로세스에서 실행하더라도 Metrics·Logs·Traces는 서로 독립된 파이프라인으로 연결된다.
10. 신호별 수집·전달 방식 최종 비교
| 신호 | 발생 형태 | Source → Alloy | Alloy → Backend | 저장 Backend |
| Metrics | 누적값 및 현재 상태 | /metrics Pull 또는 OTLP Push |
Remote Write Push | Prometheus / Mimir |
| Logs | 개별 이벤트 | File Tail/Read 또는 OTLP Push | Loki Push | Loki |
| Traces | 요청 경로를 구성하는 Span | OTLP Push | OTLP Push | Tempo |
핵심 흐름을 축약하면 다음과 같다.
Metrics = Pull로 수집하고 Push로 전달할 수 있다.
Logs    = 파일을 읽거나 Push로 받은 뒤 Loki로 Push한다.
Traces  = 애플리케이션부터 Tempo까지 주로 Push로 전달한다.
Push와 Pull은 텔레메트리 종류 하나에 영구적으로 고정되는 속성이 아니다. 동일한 메트릭이라도 애플리케이션에서 Alloy까지는 Pull, Alloy에서 Backend까지는 Push를 사용할 수 있다. 따라서 수집 방식을 설명할 때는 어느 Component가 어느 대상으로부터 데이터를 가져오거나 보내는지를 함께 명시해야 한다.
요약
- 세 가지 신호: 메트릭은 집계된 상태, 로그는 개별 사건, 트레이스는 요청이나 작업의 전체 경로를 나타낸다.
- Backend: Grafana 생태계에서는 메트릭을 Prometheus 또는 Mimir, 로그를 Loki, 트레이스를 Tempo에 저장한다.
- Alloy: 세 Backend를 대체하는 저장소가 아니라 텔레메트리의 수집·가공·전달 계층을 통합하는 Collector이다.
- 파이프라인 구성: Alloy로 메트릭만 수집하거나 메트릭·로그·트레이스를 하나의 프로세스에서 모두 수집할 수 있다.
- 메트릭 Pull: Counter와 Classic Histogram은 이벤트 결과를 누적하므로 매 이벤트를 즉시 Push하지 않아도 스크랩 사이의 증가량을 계산할 수 있다.
- 구간별 방향: 메트릭은 애플리케이션에서 Alloy까지 Pull하고 Backend로 Push할 수 있으며, 로그와 트레이스는 최종 Backend로 주로 Push된다.
틀린 부분이 있거나 인용한 부분에 대해 문제가 있을 시
댓글로 알려주시면 감사하겠습니다.